Llama 4 Behemoth Benchmark Victory
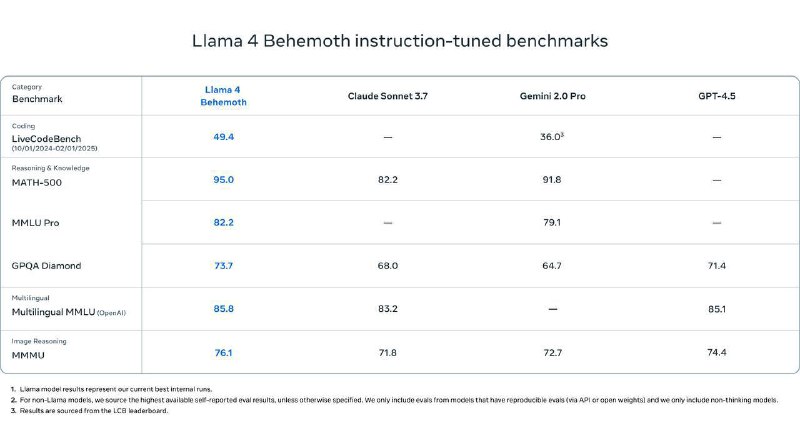
Llama 4 Behemoth instruction-tuned benchmarks Category Benchmark Llama 4 Behemoth Claude Sonnet 3.7 Gemini 2.0 Pro GPT-4.5 Coding LiveCodeBench (10/01/2024-02/01/2025) 49.4 — 36.0³ — Reasoning & Knowledge MATH-500 95.0 82.2 91.8 — MMMU Pro 82.2 — 79.1 — GPQA Diamond 73.7 68.0 64.7 71.4 Multilingual Multilingual MMLU (OpenAI) 85.8 83.2 — 85.1 Image Reasoning MMMU 76.1 71.8 72.7 74.4 1. Llama model results represent current best internal runs. 2. For non-Llama models, we source the highest available self-reported results, unless otherwise specified. We only include evals from models that have reproducible evals (via API or open weights) and we only include non-thinking models. 3. Results are sourced from the LCB leaderboard.
Таблица сравнивает результаты Llama 4 Behemoth с Claude Sonnet 3.7, Gemini 2.0 Pro и GPT-4.5 на различных тестах. Шутка в демонстративном триумфе Llama 4 Behemoth: модель заметно лидирует в большинстве приведённых бенчмарков, поэтому изображение используют как реакцию на «невероятное начало года» и победу в сравнении ИИ-моделей.
benchmark table / таблица бенчмарковwhite background / белый фонblue highlighted scores / выделенные синим оценкиcomparison chart / сравнительная диаграммаrows and columns / строки и столбцыAI model names / названия ИИ-моделейdecimal scores / десятичные баллыfootnotes / сноскиrounded table border / закруглённая рамка таблицы
- @dev_meme / 6632 2025-04-05
- Type
- image
- Size
- 800×423 · 37.5 KiB
- Mood
- triumphant
- Language
- en
- Added